
Humanoide Roboter sind heute ferngesteuerte Stahlkolosse mit ausgeklügelten Aktuatoren und einer Regelung, die ihresgleichen sucht. Sie laufen, springen und tanzen, und in vielen Demos, die autonom aussehen, sitzt ein Mensch mit Handschuhen oder VR-Brille daneben. Nutzen bringen sie so noch kaum. Damit die Versprechen der Branche eingelöst werden, müssen sie autonom werden. Greifen, fügen, dosieren, nachfassen, wenn etwas rutscht, ohne dass jemand die Hand führt. Sprachmodelle hatten für ihren Sprung das Internet, ein fertiges Archiv aus Text, das nur eingesammelt werden musste. Für das, was zwischen Fingerkuppe und Werkstück passiert, gibt es kein solches Archiv. Diese Daten existieren schlicht noch nicht. Sie müssen erst erzeugt werden, und wie das gehen soll, darüber ist sich die Branche nicht einig.
Wie viel auf dieser Frage liegt, zeigt der Sommer. Am 25. August hat Figure aus San Jose eine App angekündigt, die Menschen dafür bezahlt, sich bei der Hausarbeit zu filmen. Index hat nach Firmenangaben in vier Monaten 16 Millionen Videos aus 108 Ländern eingesammelt, 15 Millionen Dollar an die Filmenden ausgezahlt und verarbeitet jede Sekunde 30 Minuten neues Material. Für die nächsten zwölf Monate kündigt Figure über eine Milliarde Dollar für Daten und Rechenleistung an. NVIDIA baut zur selben Zeit mit Google DeepMind und Disney Research eine Physik-Engine, damit Roboter dasselbe in der Simulation lernen. China hat über 40 staatliche Datensammelzentren angekündigt, in denen Trainer mit Exoskeletten Roboter fernsteuern. Und in Zürich wird die Steuerung eines Roboters aus einem Videomodell abgeleitet, das gelernt hat, wie sich Dinge bewegen, wenn man sie anfasst.
Egal welchen Weg eine Firma wählt, die Daten müssen erst einmal entstehen. Gestritten wird darüber, wie. Mehrere Wege laufen gerade nebeneinander, auf jedem liegt Kapital, und es ist gut möglich, dass sich einer davon als Sackgasse erweist und die Milliarden darin verbrannt sind. Die Wege unterscheiden sich vor allem in einer Frage, nämlich wo die eine Größe herkommen soll, die jeder Griff braucht und die keine Kamera aufzeichnet.
Diese Größe ist Kraft. Wie sehr, haben die Physiologen Roland Johansson und Göran Westling schon in den achtziger Jahren gezeigt (Übersicht in Nature Reviews Neuroscience). Menschen passen ihre Greifkraft unmittelbar nach dem Kontakt an die Oberfläche an, glatt wird fester gehalten als rau. Betäubt man ihnen die Fingerkuppen, verschwindet diese Anpassung vollständig, obwohl sie ihre Hand die ganze Zeit sehen. Sie quetschen oder lassen fallen.
Dass das Auge die Lücke nicht schließt, liegt an der Geschwindigkeit. Beginnt ein Objekt zu rutschen, korrigiert die Hand die Greifkraft nach rund 74 Millisekunden, reflexhaft, aus der Haut heraus. Eine bewusste Korrektur braucht etwa doppelt so lang, eine über das Sehen eher länger. Bis du gesehen hast, dass das Glas rutscht, liegt es am Boden. Dafür sitzen in der Handinnenfläche rund 17.000 taktile Einheiten, und keine davon interessiert sich dafür, wie der Griff aussieht.
Eine Kamera nimmt auf, wie eine Bewegung aussieht, nicht wie viel Kraft sie gebraucht hat. Rodney Brooks, Mitgründer von iRobot, hat selbst tausende Roboter in Fabriken gebracht, und er hält die eingesammelten Daten für die falsche Art. Geschicklichkeit entsteht über den Tastsinn, über Widerstand und Rutschen in der Fingerkuppe, und genau diese Dimension fehlt in Kamerabildern und Teleoperations-Mitschnitten fast vollständig. Dass da etwas fehlt, lässt sich messen. Ein Forschungsteam von Meta hat gezeigt, dass Modelle, die Kraft und Vibration mitverarbeiten, ihre Erfolgsrate gegenüber rein bildbasierten Tastmodellen um 63 Prozent steigern.
Wo diese Kraftinformation herkommen soll, darauf gibt es mehrere Antworten, und jede ist eine eigene Art, Trainingsdaten zu erzeugen. Man kann die Kraft mit aufzeichnen. Man kann sie weglassen, dafür Masse sammeln und darauf setzen, dass der Roboter sie zur Laufzeit selbst nachregelt. Man kann den Roboter beim Sammeln gleich ganz weglassen. Oder man kann die Kraft berechnen. Jeder Weg hat einen Vorteil, jeder hat ein Risiko, und keiner ist bewiesen.
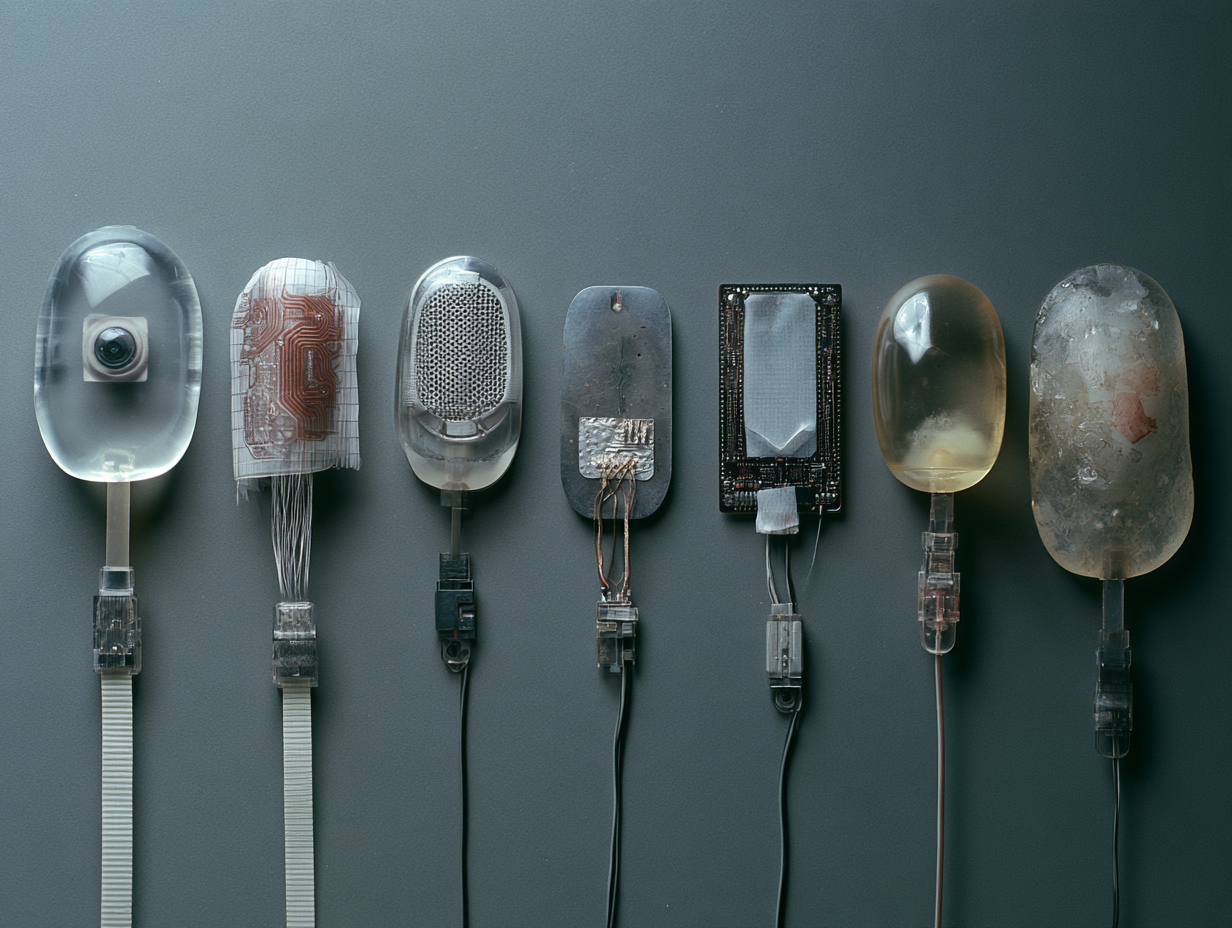
Kraft mitschreiben heißt, beim Erzeugen der Daten nicht nur aufzunehmen, wie ein Griff aussieht, sondern zu messen, was er tut. Am Handgelenk des Roboters sitzt ein Kraft-Momenten-Sensor, in den Fingerkuppen sitzen Tastsensoren, und während ein Mensch die Maschine fernsteuert, wird jedes Newton mitgeschrieben, mit dem der Greifer zudrückt, und jeder Moment, in dem das Teil zu rutschen beginnt. Der Datensatz RH20T macht genau das, Kraft, Drehmoment, Bild, Ton und Gelenkstellung synchron, rund 1.100 Stunden, und ist damit die belegte Ausnahme im Feld. Der Vorteil liegt auf der Hand. Auf diesem Weg steht die Kraft als einzigem wirklich in den Daten.
Das Risiko steckt im Sensor. Tastsensoren gibt es in vielen Bauformen, Fingerkuppen mit einer Kamera hinter einem weichen Gel, das sich beim Kontakt verformt, Folien, die Druck über Widerstand oder Kapazität messen, Glasfasern, Mikrofone, die die Vibration beim Rutschen hören. Jede Bauform liefert ein anderes Signal. Der Gel-Sensor liefert ein Bild seiner Verformung, die Folie eine Zahlenreihe, das Mikrofon eine Tonspur. Ein Modell, das an einem Sensor gelernt hat, wie „rutscht gleich“ aussieht, erkennt dasselbe Ereignis am nächsten Sensor nicht wieder, weil das Signal eine andere Form hat, und selbst zwei Exemplare derselben Bauform weichen durch Fertigungstoleranzen voneinander ab. Für Bilder gab es irgendwann ImageNet, einen Datensatz, auf dem alle aufbauen. Für Tastdaten gibt es keinen Standard, und deshalb wächst nichts zusammen. Dazu kommt der Verschleiß. Ein Gel nutzt sich ab, im Schleiftest in Sekunden, im Betrieb über Wochen, und liefert dann für denselben Griff ein anderes Signal als am ersten Tag. Robustere Bauformen halten länger, aber auch ihnen fehlt der gemeinsame Nenner. Wer diesen Weg geht, bindet seine Daten an eine Hardware. Verschwindet sie vom Markt, verschwinden die Daten mit. Beim lange verbreiteten BioTac-Sensor ist genau das passiert, er ist abgekündigt, und ältere Datensätze veralten mit ihm.
So argumentiert der zweite Weg. Kraft muss gar nicht im Datensatz stehen, weil sie am Roboter ohnehin entsteht. Jeder Motor zieht Strom, und der Strom verrät das Drehmoment. Ein Kraft-Momenten-Sensor am Handgelenk misst, was am Werkstück anliegt. Impedanzregelung, also den Arm gezielt nachgiebig zu machen statt ihn starr auf Position zu fahren, fügt seit Jahrzehnten Stifte in Bohrungen, inzwischen mit Toleranzen unter einem Zehntelmillimeter. Das Modell lernt aus Video den Plan, die Maschine regelt die Kraft nach. Deshalb sammelt dieser Weg das, was sich billig und in Masse sammeln lässt, Bilder und Bewegungen.
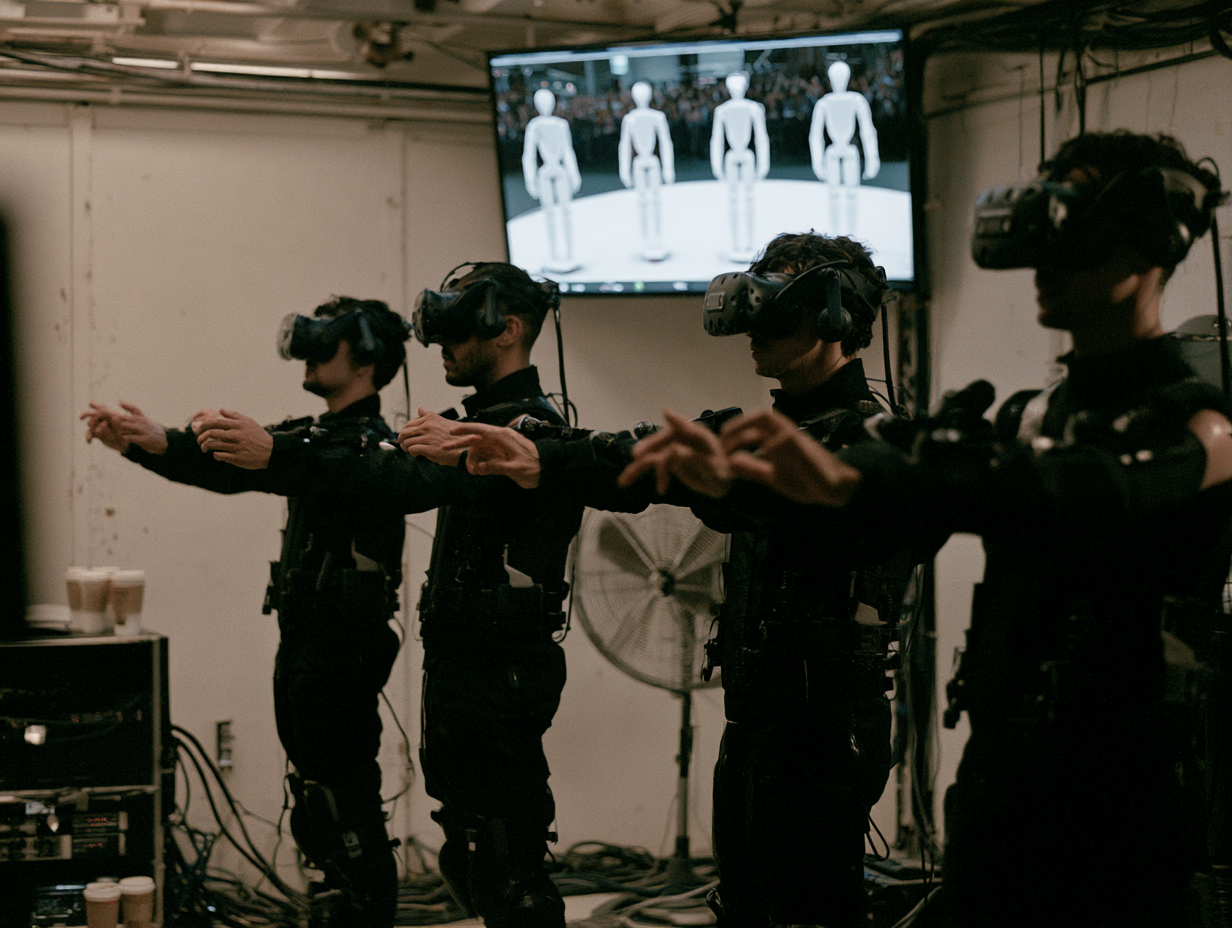
Die Masse kommt aus zwei Quellen. Die erste sind Datenfabriken. AgiBot World aus Shanghai umfasst rund eine Million Trajektorien, also aufgezeichnete Bewegungsabläufe, knapp 3.000 Stunden aus einer einzigen Halle, in der Menschen Roboter fernsteuern, ohne dass je ein Produkt herausrollt. Rest of World zählte zuletzt über 40 angekündigte staatlich geförderte Zentren dieser Art in China. Was in fast allen diesen Stunden steht, sind Bilder und Gelenkwinkel. Wie fest ein Griff war, ob etwas nachgab oder zu rutschen begann, steht in aller Regel nicht drin. Ich nenne solche Daten kraftblind.
Die zweite Quelle sind Menschen, die sich selbst filmen. Bei Index trägt ein Creator, so nennt Figure die Filmenden, eine Kamera am Kopf, räumt die Küche auf, faltet Wäsche oder packt im Lager Kartons, und wird nach Minuten bezahlt. 15 Millionen Dollar für 16 Millionen Videos, im Schnitt also unter einem Dollar pro Video. Menschen in 108 Ländern erzeugen für ein paar Dollar die Vorlage für die Maschine, die ihre Arbeit einmal machen soll, und der Kaufgrund für Figure ist die Vielfalt. Jede neue Küche ist eine, die das Modell noch nie gesehen hat. Aus solchen Daten werden Vision-Language-Action-Modelle trainiert, kurz VLA, die aus Kamerabild und Sprachbefehl direkt die nächste Bewegung vorhersagen. NVIDIA hat mit EgoScale ein solches Modell auf 20.854 Stunden egozentrischem Video trainiert, also Aufnahmen aus der Perspektive des Menschen, der gerade seine Hände benutzt, und berichtet ein sauberes Skalierungsgesetz. Mehr Stunden, vorhersagbar besseres Modell.
Gemessen wird dieser Weg in Stunden, und die Stunde ist billig geworden. Eine Stunde reale Teleoperationsdaten kostet heute nur noch einen Bruchteil dessen, was sie vor zwei Jahren gekostet hat. Nur ist die Stunde die falsche Einheit. Ein Datenzentrum kann tausend Stunden Brotschneiden aufzeichnen, obwohl zehn gereicht hätten. Eine Studie von 2024 mit über 40.000 Demonstrationen fand, dass die Leistung eines Roboters mit der Vielfalt an Umgebungen und Objekten wächst und die Menge pro Umgebung ab rund 50 Demonstrationen keine Rolle mehr spielt. Tausend Stunden Brotschneiden machen keinen Roboter geschickt, wenn zehn gereicht hätten und die entscheidende Größe gar nicht aufgezeichnet wurde.
Belegt ist auf diesem Weg, dass ein Roboter Dinge greifen kann, die er nie gesehen hat. Robuste, kraftgeregelte Kontaktarbeit steht noch aus, und darin liegt das Risiko. Ein Kraft-Momenten-Sensor am Handgelenk misst die Summe, nicht die Stelle am Finger, an der die Kraft angreift. Für einen Stift in einer Bohrung reicht die Summe. Für ein rohes Ei, ein Kabel oder einen Reißverschluss entscheidet, welcher Finger wo wie fest drückt, und ob etwas zu rutschen beginnt, lange bevor das Handgelenk davon etwas merkt. Auf diesem Weg liegt das meiste Geld, und deshalb ist sein Risiko das größte. Stellt sich heraus, dass Video die Kraft nicht ersetzt, dann steht am Ende ein Archiv aus Milliarden Clips, für das Milliarden bezahlt wurden und das keinen Roboter geschickter macht.
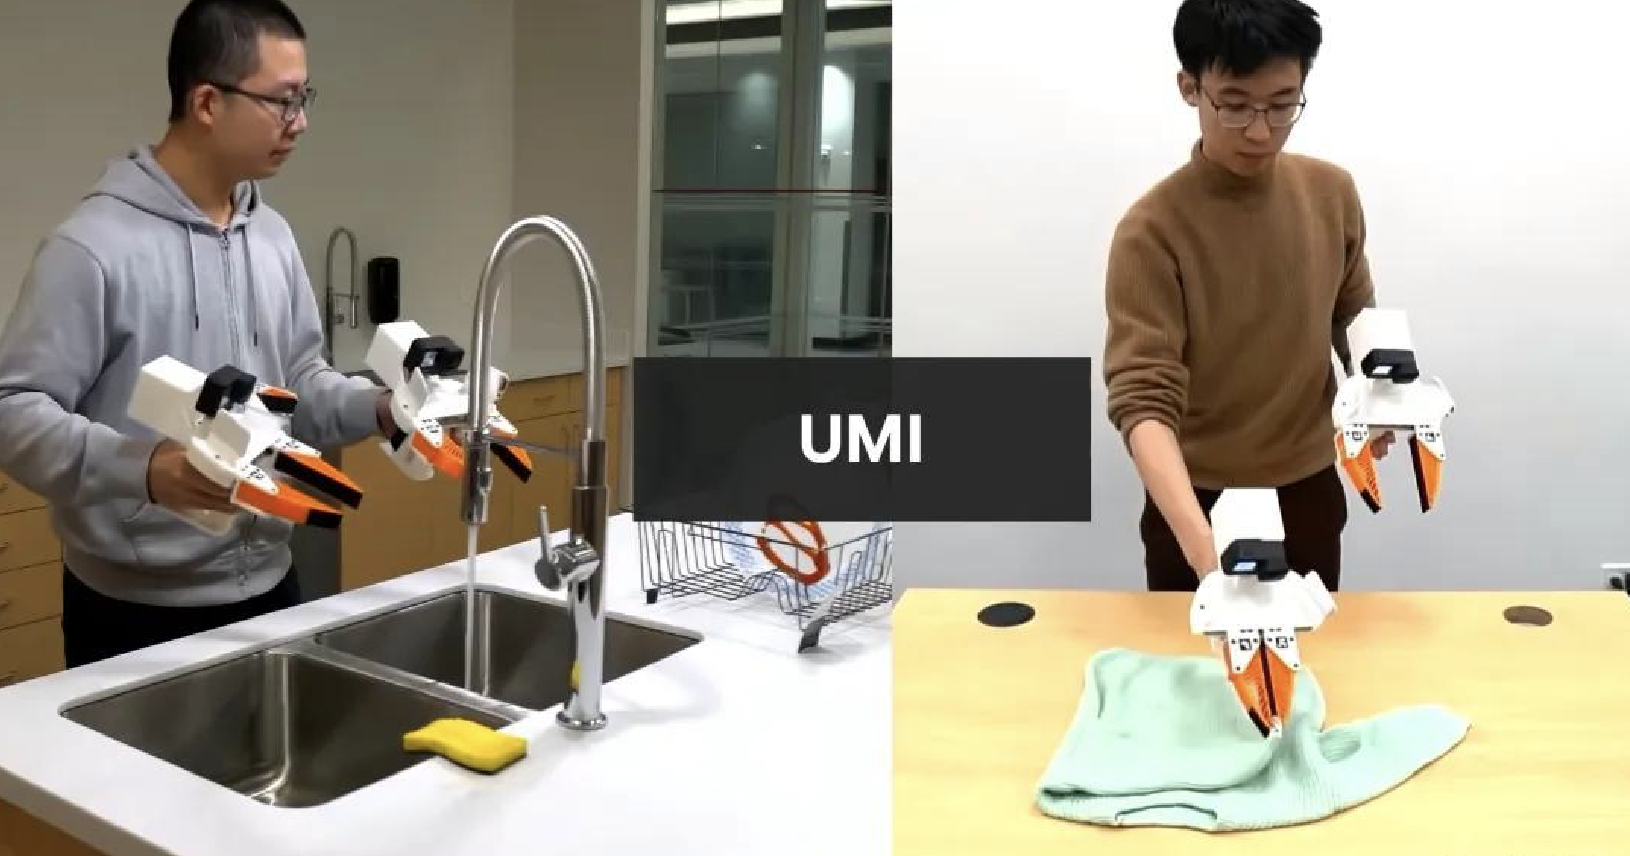
Der dritte Weg spart den Roboter beim Sammeln ganz ein. Der bekannteste Ansatz heißt UMI, eine Actionkamera auf einem handgehaltenen Greifer, mit dem ein Mensch Aufgaben vormacht. Die Kamera zeichnet auf, was der Greifer sieht und wie er sich bewegt, und daraus lernt später ein Roboter mit demselben Greifer. Der Vorteil ist der Preis. Kein Roboter im Raum, keine Halle, keine Fernsteuerung, jeder kann überall sammeln. Das Risiko ist dasselbe wie beim Video, nur ohne den Roboter, der die Kraft wenigstens später nachregeln könnte. Die Daten sind kraftblind, und die Position, die die Kamera aus dem Bild errechnet, driftet bei langen Aufgaben weg. Eine Weiterentwicklung, TacUMI, baut Tastsensoren und Kraftmessung in den Greifer ein, und sofort wird die Hardware teurer und empfindlicher, der Durchsatz sinkt, und der Weg erbt alle Sensorprobleme aus Weg eins.
Wer keine Kraft aufzeichnen und keine nachregeln will, kann sie berechnen. In der Simulation üben tausende Maschinen gleichzeitig, jeder Versuch kostet Strom statt Bauteile, und niemand muss ein Werkstück aufheben, das auf den Boden gefallen ist. Das ist der Vorteil, und er ist gewaltig. Für den Abstand zwischen dem, was ein Roboter in der Simulation lernt, und dem, was davon in der Wirklichkeit übrig bleibt, hat die Branche einen eigenen Begriff, den Sim-to-Real-Gap. Wie groß er beim Greifen ist, hat das Pekinger Trainingszentrum X-Humanoid gemessen. Ein Roboterarm soll einen umgekippten Becher aufrichten. In der Simulation gelingt ihm das in neun von zehn Versuchen. Nur mit Simulationsdaten trainiert und auf die echte Maschine gebracht, gelingt es in einem von zehn. Der häufigste Grund war ein Becher, der beim Drehen aus dem Greifer rutschte, weil der nicht fest genug zugepackt hatte. In der Simulation hatte derselbe Griff gereicht.
Der Grund ist die Oberfläche. Wie rau ein Becher ist, wie ein Kabel nachgibt, wie viel Spiel ein Getriebe hat, all das lässt sich bisher nicht so genau berechnen, wie es der Griff braucht. Beim Test am echten Roboter passieren dann Dinge, die in der Simulation nie vorgekommen sind, und der Griff scheitert an ihnen. In einem Vergleich gängiger Physik-Engines an Stoff traf keine einzige die dynamische Manipulation exakt. Genau hier wird gerade investiert. NVIDIA hat mit Google DeepMind und Disney Research die quelloffene Physik-Engine Newton aufgesetzt, seit Version 1.0 mit hydroelastischer Kontaktmodellierung, also verteilten Druckflächen statt eines einzelnen Kontaktpunkts. Als Beimischung wirkt Simulation schon heute, dieselbe Pekinger Messung zeigt, dass Simulationsdaten neben echten die Trefferquote auf der echten Maschine heben. Sie wirken als Vorstufe, als Grundausbildung. Den letzten Zentimeter bildet bisher keine Engine so ab, dass man dem Ergebnis eine Fertigung anvertrauen würde.
Einen anderen Rechenweg gehen Videomodelle. Ein Modell, das aus Milliarden Clips gelernt hat, glaubwürdige Videos zu erzeugen, muss dabei auch gelernt haben, wie sich Dinge bewegen, wenn man sie anfasst, sonst würde jeder Clip falsch aussehen. Das Zürcher Unternehmen mimic nutzt dieses Wissen. Es baut seine Robotersteuerung auf dem Videomodell von Black Forest Labs auf und bringt ihm bei, statt des nächsten Bildes die nächste Bewegung des Roboters auszugeben. Nach eigenen Angaben reichen dann 30 Minuten Aufnahmen vom echten Roboter, wo bisher 30 Stunden nötig waren, im Einsatz unter anderem bei Audi. Das Risiko dieses Wegs heißt Halluzination. In einer aktuellen Arbeit zu solchen Modellen springt ein Objekt in den Greifer, ohne dass er es vorher berührt hat. Und die 30 Minuten stammen vom echten Roboter. Auch der eleganteste Weg der Branche endet dort, wo die Kraft zum ersten Mal wirklich anliegt.
Wer die Kraft mitschreibt, hat die richtigen Daten und kann sie kaum vermehren, weil jeder Sensor sein eigenes Signal liefert, das kein anderer Sensor versteht, und weil er sich abnutzt. Das Risiko ist, mit viel Aufwand Daten zu erzeugen, die nur mit einer Hardware funktionieren, die es in ein paar Jahren nicht mehr gibt. Wer Masse sammelt, hat Millionen Stunden und Milliarden Dollar, und die Kraft muss nachträglich aus der Regelung entstehen, was für den Stift in der Bohrung belegt ist und für das rohe Ei nicht. Das Risiko ist ein Videoarchiv, für das Milliarden bezahlt wurden und das nie enthielt, worauf es ankam. Wer den Roboter beim Sammeln weglässt, sammelt am billigsten und trägt dasselbe Risiko wie die Masse, ohne den Roboter, der nachregeln könnte. Wer rechnet, bekommt Menge fast umsonst und verliert den letzten Zentimeter, an dem sich entscheidet, ob das Teil gehalten wird. Das Risiko ist ein Roboter, der in der Simulation alles kann und in der Halle nichts. Es ist zugleich der einzige Weg, der die drei anderen über Nacht alt aussehen lassen könnte, falls Kontakt eines Tages so gut berechnet wird wie heute das Laufen.
Alle vier Wege laufen heute nebeneinander, und keiner hat sich vom anderen getrennt. Figure setzt auf Masse und regelt nach. NVIDIA setzt auf Masse und auf Simulation zugleich. Die Datenfabriken in China setzen auf Stunden. Die Forschung setzt auf Sensoren, für die es keinen Standard gibt. Gewonnen hat keiner, ausgeschieden ist keiner, und die Milliarden verteilen sich auf alle. Genau das macht die Lage für jeden, der in diesem Feld baut oder investiert, so unbequem. Man kann heute nicht sagen, welcher Weg einen Roboter zuerst autonom macht, und man kann nicht sagen, ob die Wege sich irgendwann treffen oder ob drei davon enden, sobald der vierte funktioniert. Die Branche hat Millionen Übungsstunden und weiß nicht, ob sie die richtigen sind. Was sie sicher weiß, ist nur, wo die Kraft am Ende gemessen wird, an der ersten echten Schraube, in der ersten echten Halle. Wer sie bis dahin in seine Daten bekommt, und ob es die Stunden überhaupt sind, die fehlen, das ist die offene Frage dieses Rennens.
Wenn ihr auf einem dieser Wege unterwegs seid und nach außen erklären müsst, warum eure Daten die richtigen sind, schreib mir. Ich helfe mit Lucent Deep-Tech-Teams dabei, technische Substanz in eine Erzählung zu übersetzen, die Kunden und Investoren verstehen.